Monitorando crédito privado com Databricks Real-Time
TL;DR
- Exploramos um MVP de monitoramento de crédito privado combinando consultas diretas ao lakehouse governado no Unity Catalog com snapshots em memória no backend.
- Comparamos o warehouse serverless anterior com um Databricks Real-Time (RT) compartilhado: as medianas de duração no warehouse caíram entre 71,8% e 87,8% nos três perfis medidos.
- Nos logs do cliente SQL no backend, o p95 caiu 3.864,55 ms (49,7%), saindo de 7.770,16 ms para 3.905,61 ms.
- As medições refletem execução de consulta e trecho instrumentado do backend — não tempo de carregamento de página nem garantia sob concorrência sustentada.
O saldo total não explica quais recebíveis concentram a exposição ou compõem os atrasos. Essa análise exige recortes consistentes entre carteiras, devedores e títulos individuais.
Na CERC, exploramos esse problema em um produto mínimo viável (MVP) de monitoramento de crédito privado. O cliente é uma securitizadora que atua nesse mercado. Faz parte da nossa cultura de engenharia testar continuamente novas tecnologias e abordagens para resolver desafios reais dos nossos clientes, parceiros e da própria operação — na mesma linha do nosso experimento anterior com Lakehouse Real-Time. Este artigo aborda implementação e medições, não uma garantia de desempenho em escala de produção.
A implementação combina consultas diretas ao lakehouse com snapshots em memória no backend. Comparamos o warehouse serverless anterior com um Databricks Real-Time (RT) compartilhado. As medianas de duração caíram entre 71,8% e 87,8%, conforme o perfil de consulta. O p95 medido pelo cliente SQL no backend caiu 3.864,55 ms (49,7%).
São medições de consultas, não do tempo de carregamento da página no navegador. Entender esse limite é tão importante quanto observar as melhorias.
O caminho dos dados
Um portal React/Vite chama um backend NestJS hospedado no Google Kubernetes Engine (GKE). O backend consulta uma tabela analítica governada pela API de execução SQL do Databricks. O Unity Catalog governa o acesso à tabela; o backend autoriza usuários e filtra respostas.
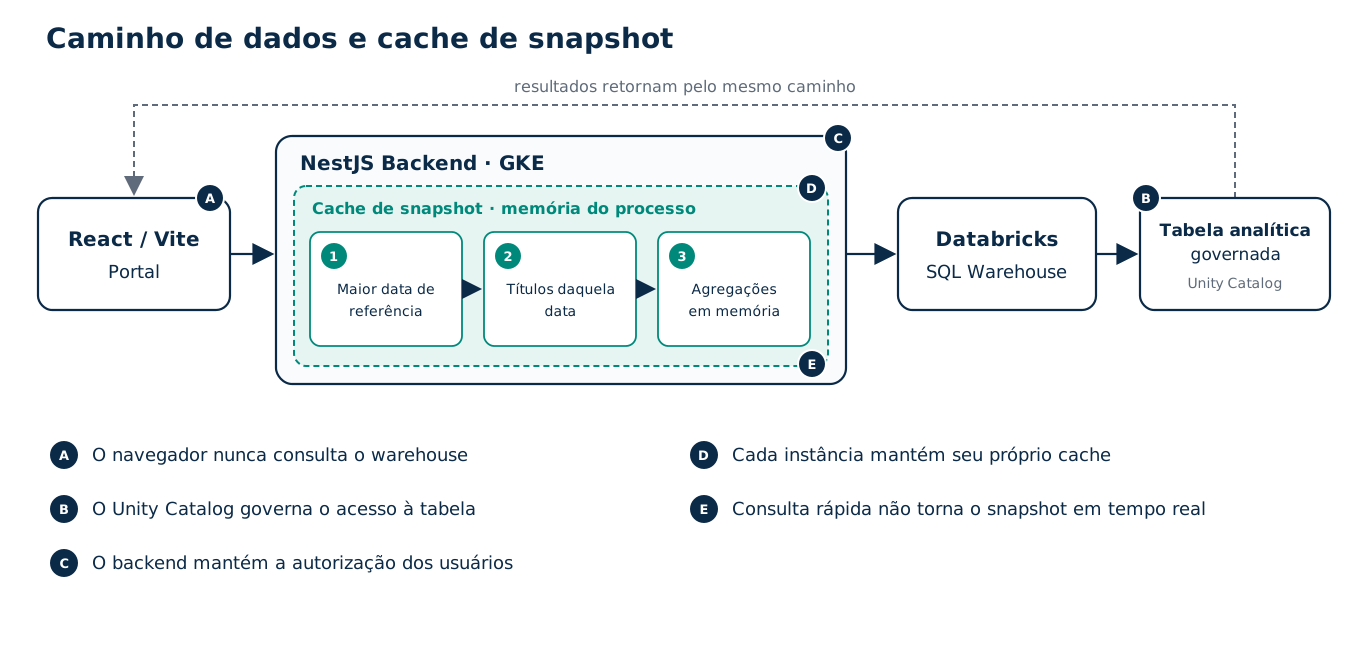
As setas representam requisições e leituras. Os resultados retornam pelo mesmo caminho.
A tabela reúne identificadores de carteiras e títulos, devedores, datas, valores e situação dos pagamentos. Para as agregações baseadas em snapshot, o backend executa duas consultas:
- Identifica a maior data de referência disponível na tabela.
- Carrega os recebíveis correspondentes àquela data.
O snapshot observado continha aproximadamente 29.354 registros. O backend reutiliza essas linhas em agregações, evitando repetir cada agrupamento em SQL. Outros endpoints ainda podem executar suas próprias consultas.
Essa escolha troca trabalho repetido no warehouse por memória e processamento na aplicação. O tamanho do snapshot e o número de instâncias importam para dimensionar o backend. O acesso direto evita uma réplica relacional dedicada, mas não elimina cópias em memória. Este benchmark compara warehouses, não Databricks contra um banco relacional ou Redis.
Validade do cache e atualidade dos dados
O cache usa chaves por organização, com validade configurada e limitada à meia-noite UTC. A atualização manual pode invalidar entradas; reinícios e novas instâncias podem provocar novas cargas. Cada instância mantém seu próprio cache, sem garantia de uma única consulta diária.
O snapshot mais recente pode ter uma data de referência anterior ao dia atual. Consultas rápidas não tornam esse conjunto mais recente. A atualidade depende da ingestão, do processamento na origem e da renovação do cache. O nome Real-Time não transforma snapshots diários em atualizações contínuas por eventos.
Identidade e acesso
O backend usa identidade de workload e tokens de identidade Google, sem chave estática embutida. O workload é a carga computacional que executa a aplicação. O navegador nunca consulta o warehouse diretamente. Permissões da tabela e autorização da aplicação continuam sendo responsabilidades distintas.
O que medimos
Usamos duas fontes com limites diferentes:
- Histórico de consultas Databricks: o campo
total_duration_msregistrado pelo warehouse. - Logs do backend: tempo decorrido no trecho instrumentado do cliente SQL.
O p50 representa a mediana; o p95 descreve a parte superior da distribuição amostrada. Nenhum deles representa um tempo de resposta garantido.
Duração das consultas no Databricks
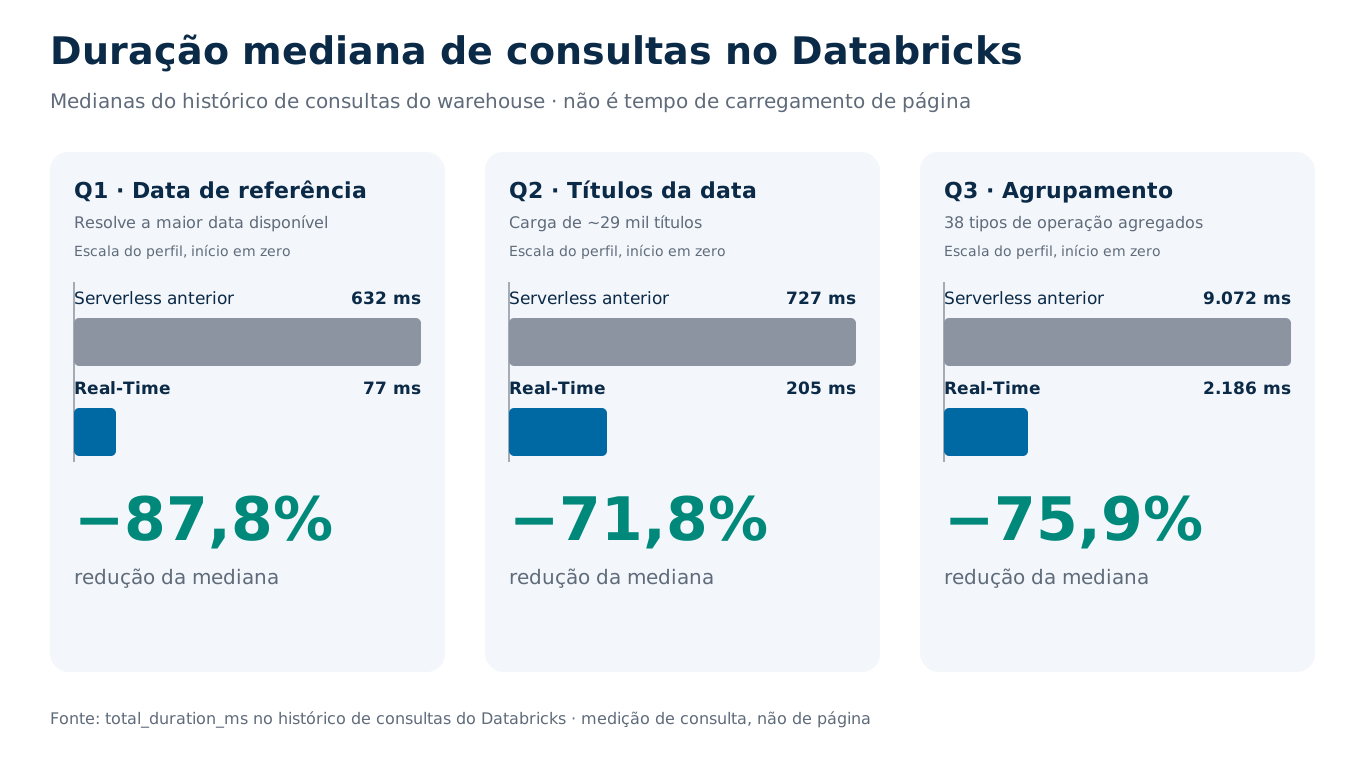
Q1 identifica a data de referência. Q2 carrega os recebíveis daquela data. Q3 retorna um agrupamento de 38 tipos de operação no conjunto observado.
| Perfil | Amostras: anterior / RT | p50 anterior (ms) | p50 RT (ms) | Redução (ms) | Redução (%) |
|---|---|---|---|---|---|
| Q1: data de referência | 18 / 7 | 632 | 77 | 555 | 87,8 |
| Q2: aproximadamente 29 mil títulos | 11 / 7 | 727 | 205 | 522 | 71,8 |
| Q3: agrupamento de 38 tipos de operação | 7 / 7 | 9.072 | 2.186 | 6.886 | 75,9 |
Q3 retornou menos linhas que Q2, mas demorou mais nos dois ambientes. A quantidade de linhas retornadas não descreve sozinha o trabalho necessário para executar uma consulta. Q3 também apresentou a maior redução absoluta da mediana: 6.886 ms.
A mediana de 205 ms de Q2 vem do histórico de consultas Databricks. Não representa somente a execução do motor nem a transferência completa até o navegador. Combinar os perfis também misturaria proporções diferentes de amostras; a tabela mantém os perfis separados.
Latência registrada pelo backend
A amostra anterior cobre 15 a 18 de setembro de 2026, com 157 consultas bem-sucedidas. A amostra RT cobre 22 a 23 de setembro de 2026, com 21 consultas bem-sucedidas. Os dois períodos usam UTC.
| Métrica | Anterior (ms) | RT (ms) | Redução (ms) | Redução (%) |
|---|---|---|---|---|
| p50 | 3.039,46 | 2.350,69 | 688,77 | 22,7 |
| p95 | 7.770,16 | 3.905,61 | 3.864,55 | 49,7 |
| p99 | 11.663,67 | 4.198,65 | 7.465,02 | 64,0 |
| Máximo observado | 14.668,98 | 4.198,65 | 10.470,33 | 71,4 |
A melhoria relativa foi maior no p95 do que na mediana. Isso indica esperas longas menores nessas amostras, além de uma consulta típica mais rápida. O p99 RT coincide com o máximo observado, refletindo o tamanho reduzido da amostra.
Onde o cronômetro começa e termina
O cronômetro do backend começa depois da obtenção do token. Inclui envio da consulta, acompanhamento quando necessário e leitura da resposta até o evento de log. Termina antes de buscar partes adicionais do resultado e transformar as linhas retornadas.
| Incluído | Não incluído |
|---|---|
| Envio da consulta SQL | Obtenção do token |
| Acompanhamento da execução | Partes adicionais do resultado |
| Leitura da resposta até o evento | Transformações e agregações posteriores |
| Entrega pela API e renderização no navegador |
O p95 do backend não comprova carregamento de página abaixo de quatro segundos. Subtrair medianas independentes também não isola os custos de rede, autenticação ou agregação. Isso exige medições correlacionadas entre etapas da mesma requisição.
Limites da comparação
Esta foi uma comparação observacional, não um experimento controlado com cargas equivalentes. Os seguintes limites importam para interpretar os resultados:
- Sete execuções RT por perfil. Percentis altos são sensíveis a observações individuais.
- Períodos e tamanhos diferentes. Carga, capacidade e condições de cache não foram controladas.
- Somente consultas bem-sucedidas. As amostras não medem taxas de falha ou disponibilidade.
- Correspondência aproximada dos perfis. SQL mascarado exige comparar contexto e formato dos resultados.
- Sem teste prolongado de concorrência. As medições não estabelecem escalabilidade ou teto de latência.
A evidência sustenta durações menores nas amostras RT observadas. Não isola todas as causas nem comprova a eliminação de inicializações a frio. Também não demonstra economia financeira, ganho de produtividade ou redução de risco de crédito.
Aprendizados de engenharia
Acesso direto ao lakehouse e agregações no processo funcionaram juntos na carga medida deste MVP. As contrapartidas permanecem concretas: dependência do warehouse, uso de memória, renovação do cache e autorização.
Três distinções tornam os resultados úteis além desta implementação:
- Atualidade não é latência. Preserve a data de referência junto aos indicadores da carteira.
- Tempo de consulta não é carregamento de página. Defina os limites de cada cronômetro.
- Um snapshot tem custo. Considere transferência, memória e cargas repetidas entre instâncias.
As melhorias observadas são relevantes dentro desses limites. Explicitá-los torna o estudo reproduzível e evita transformar um benchmark em promessa.
A CERC opera a infraestrutura do mercado financeiro brasileiro para registro de recebíveis. Se você quer trabalhar com engenharia de dados e arquitetura em problemas reais de escala, conheça nossas vagas abertas.
Este post foi escrito por: Guilherme Araújo de Oliveira.